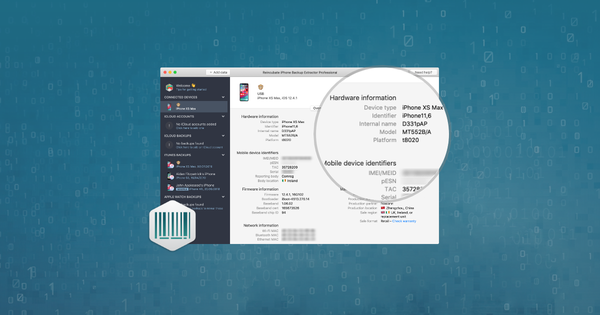


We zijn enthousiast over de lancering van Reincubate Lookup vandaag. Het beantwoordt een vraag die gebruikers steeds weer stelden: kunnen we aan de hand van een serienummer of IMEI van een Apple-apparaat het apparaat en zijn mogelijkheden nauwkeurig identificeren?
- Wie iPhones of iPads koopt op eBay, wil misschien de specificaties controleren (vooral de leeftijd en de opslagcapaciteit van het apparaat). Met het serienummer of IMEI uit de advertentie kunnen ze de specificaties controleren en zelfs nagaan of het apparaat vergrendeld is verkocht. Hier is een voorbeeld van een opzoeking van een serienummer voor een apparaat dat met een providerslot is verkocht.
- Ontwikkelaars moeten hun apps vaak testen op specifieke versies van iOS. Tweedehands apparaten met een oudere iOS vinden is als goud zoeken, maar wij kunnen de versie bepalen waarmee een apparaat is geleverd, zodat een hoop advertenties afvallen.
- Sysadmins die verantwoordelijk zijn voor vloten van apparaten krijgen van MDM-tools maar beperkte specificaties en apparaatgegevens. Bedrijven en instellingen gebruiken de technologie achter Reincubate Lookup al om hun inventarisgegevens van apparaten aan te vullen.
Reincubate Lookup, klaar om een Apple-serienummer of IMEI op te zoeken
Klanten en gebruikers stuurden onze API het afgelopen jaar meer dan 13 miljoen verzoeken om apparaatinformatie, en dat gaf ons de drijfveer om dieper te gaan.
De belofte van Reincubate Lookup is eenvoudig: geef een Apple-serienummer of een IMEI, en het levert nauwkeurige, ethische en gebruiksvriendelijke gegevens. Elk onderdeel van die belofte heeft voor ons een bijzondere betekenis, en er is een verhaal over waarom ze belangrijk zijn. Laten we kijken.
Gebruiksvriendelijk
Er komt veel jargon kijken bij het leren over mobiele apparaten, dus we hebben tijd besteed aan het bedenken van de beste manier om de informatie die het toont te ordenen, te presenteren en te labelen. We houden een paar gegevenspunten achter die waardevol kunnen zijn voor sommige technische gebruikers, maar andere mensen in verwarring kunnen brengen.
De waarde van apparaatgegevens en de moeite die consumenten hebben om de betrouwbaarheid ervan te beoordelen, hebben geleid tot een aantal diensten die deze gegevens leveren en ze afschermen met een reeks afschuwelijke en onvriendelijke mechanismen om te voorkomen dat anderen ze scrapen. Wij kozen ervoor een vervelend captchasysteem te vermijden en hebben Lookup supersnel gemaakt en zo gebouwd dat het werkt zonder tussenliggende laadpagina’s.
Opvallend genoeg, gezien het gegevens over mobiele apparaten betreft, hebben maar weinig vergelijkbare diensten interfaces die goed werken op telefoons of tablets. Wij wilden iets dat mobielvriendelijk en internationaal bruikbaar is.
Ik hoop dat we de toegankelijkheid van Reincubate Lookup goed hebben aangepakt. Het is uitgebreid getest op iPhones en iPads en we vinden dat het er best mooi uitziet. Het ondersteunt de donkere modus native en keert zijn kleurenpalet om om vermoeide ogen te verlichten. Het vraagt je niet om een captcha en is beschikbaar in 11 talen.
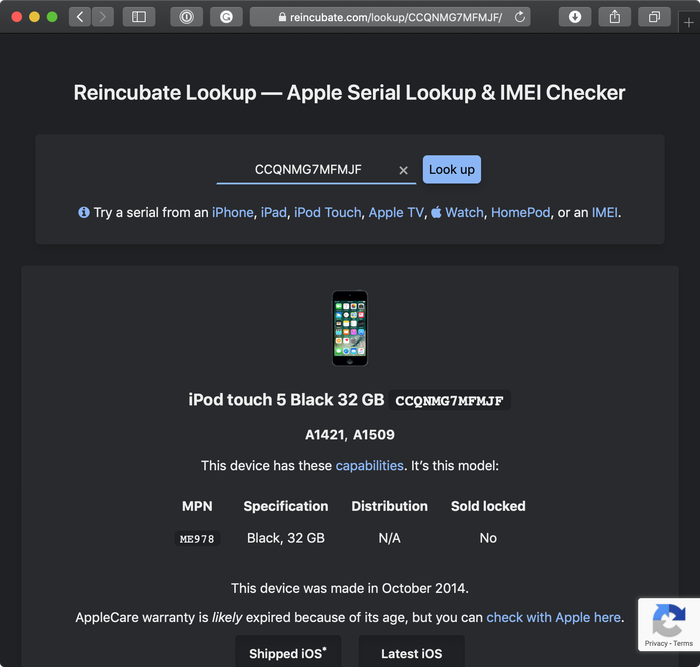
De donkere modus van Reincubate Lookup
Nauwkeurig
We hebben veel geleerd over deze gegevens sinds we in 2017 begonnen met het bouwen van onze API voor apparaatidentificatie (en afgelopen zomer ondersteuning leverden voor uitgebreide apparaatmetadata in iPhone Backup Extractor), en we kwamen een aantal moeilijke problemen tegen die we wilden oplossen.
Een van de eerste dingen die we leerden, is dat de gegevens achter Apples identificatiecodes, om eerlijk te zijn, een rommeltje zijn. Apple zelf heeft geen enkele canonieke modelidentificatie en geen consistente interne naamgeving. In sommige gevallen, iPhone 3G, we hebben het over jou, worden dezelfde ID’s zelfs hergebruikt voor verschillende producten.
Ik heb tijdens een prettige WWDC gehoopt tekenen van interne consistentie te ontdekken bij ingenieurs en managers van Apple, maar zelfs zij uitten hun frustratie erover. Bovendien is de documentatie van Apple over modelidentificatie inconsistent, en bijna elke vorm van identificatiecode (er zijn 12 hoofdvormen) wordt in hun documentatie wel een keer een “model” genoemd.
De identificatiecodes die Apple gebruikt, zijn in de loop der tijd ook veranderd. Er zijn drie verschillende serienummerformaten, binnenkort vier, en twee verschillende UDID-formaten. Familienummers begonnen ooit betrouwbaar met “M” en beginnen nu alleen nog met “A”, terwijl sommige MPN’s nu juist met “M” beginnen. En zo gaat het door.
Er zijn al verschillende opzoektools op het web, maar het kost niet veel moeite om er foute gegevens in te vinden. Meestal is dat structureel: de tools, zoals die van Everymac, zijn gebaseerd op waargenomen verbanden tussen identificatiegegevens die waar lijken te zijn… totdat ze dat niet zijn. Sommige tools hebben genoeg gegevens om dit te herkennen, waardoor een zoekopdracht een reeks mogelijke resultaten oplevert in plaats van één definitief resultaat. Andere leveren gegevens die er bijna goed uitzien… maar dat niet zijn.
Structurele gegevensproblemen zijn niet het enige probleem. Veel van deze systemen hebben gebrekkige gegevensbronnen: ze vertrouwen op scraping van Apples GSX-service, invoer door technici of, het ergst van al, gegevensinvoer door willekeurige gekken die het web afstruinen.
Om dit goed te doen, wilden we aan drie voorwaarden voldoen:
- Het systeem moet zoveel mogelijk automatisch en zelfstandig leren, want alles wat regelmatige gegevensinvoer, bewerking of moderatie vereist, veroudert snel.
We needed... a learning computer - Het systeem mag niet vertrouwen op gegevens zonder licentie of op onbetrouwbare gegevens. De iPhone Wiki heeft wat gegevens (en wij hebben er een hoop aan bijgedragen), maar die zijn niet genormaliseerd en niet helemaal nauwkeurig. De GSX-API’s van Apple hebben wat gegevens, maar ook die zijn niet genormaliseerd, bevatten in sommige gevallen echt vreemde dingen en zijn niet gelicentieerd voor gebruik op deze manier.
- Het systeem moet gegevens en resultaten opleveren waar we volledig vertrouwen in hebben, in plaats van vaak goed te zijn. Waar dus geen enkel antwoord beschikbaar is, of de waarschijnlijkheid van een antwoord laag is, moet het systeem dat duidelijk maken.
Ethisch
Nauwkeurigheid was echter niet de enige voorwaarde. Het duurde niet lang voordat we doorhadden waar een deel van deze gegevens in de branche vandaan kwam: van netwerken van werknemers die worden betaald om heimelijk gegevens uit interne databases te kopiëren (te stelen!).
Tot we hadden uitgezocht hoe we Reincubate Lookup konden laten werken, waren er eigenlijk maar drie bronnen van IMEI-gegevens:
- Het scrapen van Apples GSX API. Dit is in strijd met de voorwaarden van Apple en leidt ertoe dat de API-toegang wordt ingetrokken. Er is een kleine bedrijfstak van mensen die toegang tot GSX-accounts doorverkopen, ze opbranden en proberen nieuwe te krijgen. Dat werkt niet.
- Het in licentie nemen van de IMEI-database van de GSMA. Deze brancheorganisatie voor de mobiele industrie beheert het canonieke register van alle IMEI-informatie en geeft licenties op haar database met type allocation codes (TAC’s), die handig zijn voor het identificeren van apparaten. Dat klinkt ideaal, maar het is ingewikkelder dan dat, en de organisatie zelf claimt slechts 95% nauwkeurigheid voor haar “GSMA Device Map”-gegevens. Los van al het andere bevat hun database geen genormaliseerde identificatiecodes voor de apparaten die erin staan. Een TAC-opzoeking kan je simpelweg vertellen dat het apparaat een iPhone XS is. Dat is nauwelijks gedetailleerd.
De organisatie lijkt deels in oorlog te zijn met de mobiele fabrikanten die ze vertegenwoordigt: ze voert tegelijk programma’s uit om de integriteit van IMEI’s te handhaven en stelt ook dat “the GSMA does not have the responsibility or powers to stop illegal TAC and IMEI activity”. Foutieve registratie van deze gegevens komt vaak genoeg voor dat ze hun “non-compliant TAC / IMEI reporting process” sterk promoten.
Dat betekent in feite dat er twee sets gegevens zijn om over na te denken: de door de GSMA zelf opgegeven gegevens van fabrikanten, die onvolledig en onnauwkeurig zijn maar tenminste theoretisch nauwkeurig, en praktijkgegevens die nauwkeurig en genormaliseerd zijn en die je kunt opbouwen door mobiele apparaten te onderzoeken. We hebben een database van 3.000 TAC’s van Apple-apparaten moeten bouwen die uitgebreider en nuttiger is dan die van de GSMA. - Personeel bij telecombedrijven omkopen om als “dataspionnen” op te treden. Dit is dezelfde soort afschuwelijke praktijk waarmee Amerikaanse mobiele bedrijven locatiegegevens van consumenten verkopen aan premiejagers en gekken, en dezelfde manier waarop illegale “iCloud-ontgrendelingsdiensten” werken.
Sommige IMEI-diensten maken hier schaamteloos reclame voor. We vonden deze advertentie op de site van een Britse dienst:
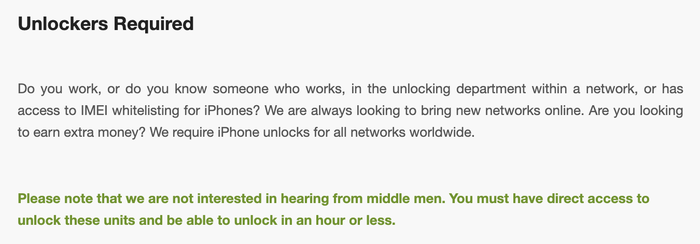
Hoe louche ontgrendelingsdiensten werken
Omdat we geen van beide benaderingen wilden gebruiken, moesten we een derde manier zoeken om de gegevens te vinden die we nodig hadden: geen spionnen, geen GSX, geen oneerlijk gedrag.
Het antwoord ligt in wezen in het analyseren van heel grote hoeveelheden gegevens, begrijpen hoe die gegevens met elkaar samenhangen en dat terugbrengen tot een reeks feiten die na verloop van tijd automatisch worden bijgewerkt. Een deel van deze gegevens is inherent aan de apparaten zelf en een deel kan worden afgeleid uit het onderzoeken van geanonimiseerde vragen over gegevens. Als genoeg zoekopdrachten de vorm hebben van “dit apparaat is A en B, is het ook C?”, kun je beginnen te begrijpen dat A en B samenhangen. Het is dezelfde techniek die ons product awdit aandreef: soms kun je antwoorden genereren als je naar genoeg vragen kijkt.
De analyse begon voor bijna elk apparaat te werken toen we ongeveer 5.000.000 zoekopdrachten in de database hadden, en waar er niet genoeg gegevens zijn om een bepaalde vraag te beantwoorden, raadt Reincubate Lookup aan om te kijken met iPhone Backup Extractor. Dat is slim genoeg om dieper te graven en de vraag aan ons door te geven.
Vanaf vandaag hebben we net geen 9.000 configuratiecodes geïdentificeerd voor 2.350 modellen, 127 verschillende productiefaciliteiten, 304 verschillende distributieregio’s en meer dan 3.000 IMEI type allocation codes.
Zo zijn we dus Reincubate Lookup gaan bouwen, en dat is waarom gebruiksvriendelijkheid, nauwkeurigheid en ethiek belangrijk waren bij het bouwen ervan. We hopen dat je het mooi vindt en dat het je waarde biedt. Wil je dieper gaan? Alle gegevens van Lookup komen uit onze DeviceIdentifier API, en we vinden het geweldig om te zien dat mensen daar dingen mee bouwen.
Laat van je horen: vertel ons gerust hoe het je bevalt.